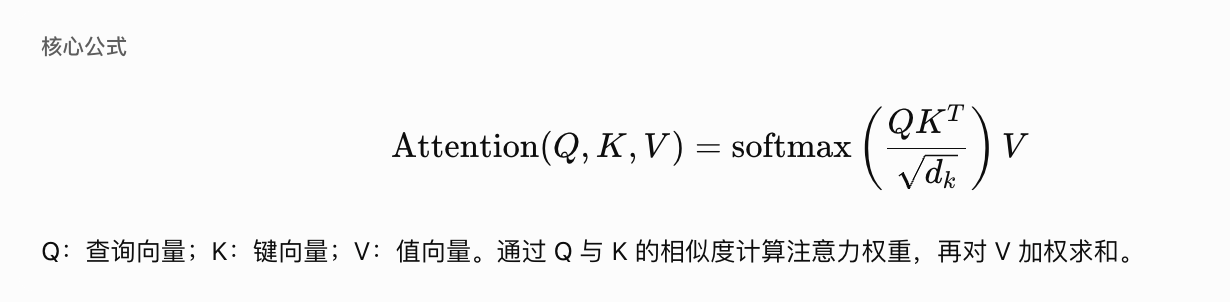
用"班级图书角"来理解注意力公式 📚
这个公式叫 注意力(Attention),是 ChatGPT、Claude 这类 AI 的核心。别怕,我们先不看公式,先讲个故事。
🎒 故事:你想找一本书
你走进图书角,想找一本"讲恐龙的书"。
- 你心里想的问题 = Q(查询,Query):"我想看恐龙!"
- 每本书封面上的标签 = K(键,Key):《恐龙大百科》《数学王国》《宇宙飞船》……
- 每本书里面的内容 = V(值,Value):书里真正的知识
你要做的事:
- 拿你的问题(Q)和每本书的标签(K)比一比,看谁最像
- 越像的书,越重视;不像的,少看一点
- 最后把重视程度加起来,得到你要的知识(V)
这就是"注意力":把注意力放在最相关的东西上。
🔍 公式一步一步拆开
$$\text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
第 1 步:$QK^T$ —— 打分
用"问题"和每个"标签"配对,算出相似度分数。
| 书 | 和"恐龙"像不像 | 分数 |
|---|---|---|
| 《恐龙大百科》 | 非常像 | 9 分 |
| 《宇宙飞船》 | 有点沾边 | 2 分 |
| 《数学王国》 | 完全不像 | 0 分 |
($T$ 只是一个"把表格转个方向"的小动作,让 Q 和 K 能配对,不用管它。)
第 2 步:$\div\sqrt{d_k}$ —— 把分数"缩小"
如果分数变得特别大(比如 900 分、20 分),后面会"一边倒",AI 就只盯着一本书,变得很死板。
所以除以一个数($d_k$ 是标签有多长),把分数按比例缩小,让大家更公平。
🍰 就像考试满分 1000 分太夸张,统一换算成 100 分,更好比较。
第 3 步:softmax —— 变成"百分比"
softmax 的作用是把分数变成加起来等于 100% 的比例:
| 书 | 注意力权重 |
|---|---|
| 《恐龙大百科》 | 90% |
| 《宇宙飞船》 | 9% |
| 《数学王国》 | 1% |
意思是:你 90% 的注意力放在恐龙书上。
第 4 步:乘以 V —— 按比例"取内容"
最后,按这些百分比,把每本书**里面的内容(V)**混合起来:
90% 的恐龙知识 + 9% 的宇宙知识 + 1% 的数学知识
得到的结果,就是 AI 最终"读懂"的信息。这就是图片下面那句话的意思:"通过 Q 与 K 的相似度计算注意力权重,再对 V 加权求和。"
🧠 放到 AI 里是什么样?
看这句话:"小明把苹果给了小红,因为她饿了。"
AI 读到"她"时:
- Q:"'她'指的是谁?"
- K:句子里每个词的标签(小明、苹果、小红……)
- 算分数后,"小红"得分最高 → 注意力集中在"小红"上
于是 AI 就明白了:"她" = 小红。
✅ 一句话总结
注意力公式 = 拿问题去和所有信息比相似度 → 缩小分数 → 变成百分比 → 按百分比把重要内容"拼"起来。
| 符号 | 小学生版解释 |
|---|---|
| Q | 我想找什么 |
| K | 每样东西的标签 |
| V | 每样东西的真实内容 |
| $QK^T$ | 问题和标签比一比,打分 |
| $\sqrt{d_k}$ | 把分数缩小,别太极端 |
| softmax | 分数变百分比 |
| 乘 V | 按百分比取内容 |